AI에게 기능을 맡기고 테스트까지 통과했다. 그런데 브라우저에서는 키보드 포커스가 사라지고, 모바일 앱은 백그라운드에서 돌아오면 입력값을 잃는다. 데이터베이스 쿼리는 결과는 맞지만 운영 환경에서 수백만 행을 훑는다.
코드가 맞는 것과 제품이 안전하게 동작하는 것은 같은 말이 아니다.
AI 검증의 공통 원칙은 분명하다. 실패를 재현하고, 작은 변경을 비교하고, 증거를 남긴다. 하지만 어떤 실패를 관찰해야 하는지는 기술 스택마다 다르다. 오늘은 프론트엔드·모바일·데이터베이스에서 놓치기 쉬운 검증 지점을 하나의 실전 체크리스트로 정리한다.
공통 테스트 하나로 모든 스택을 설명할 수 없는 이유
함수 테스트는 입력과 반환값을 비교하는 데 강하다. 하지만 실제 제품에는 반환값 밖의 세계가 있다.
- 프론트엔드에는 화면 상태, 포커스, 접근성, 뷰포트가 있다.
- 모바일에는 앱 생명주기, 권한, 센서, 기기 성능이 있다.
- 데이터베이스에는 실행 계획, 잠금, 버퍼 읽기, 데이터 분포가 있다.
그래서 AI에게 “테스트도 작성해줘”라고만 요청하면 가장 만들기 쉬운 테스트에 치우치기 쉽다. 검증 요청에는 대상 스택의 실패 유형과 실행 환경을 함께 적어야 한다.
1. 프론트엔드: 정상 화면보다 상태 전환을 검증한다
AI가 만든 UI는 데이터가 잘 도착하는 정상 경로에서 그럴듯해 보인다. 문제는 사용자가 정상 경로에만 머물지 않는다는 것이다.
장바구니 화면 하나를 예로 들어도 최소한 다음 상태가 필요하다.
상태확인할 질문
| 로딩 | 진행 상태가 보이고 중복 클릭이 막히는가? |
| 빈 결과 | 오류처럼 보이지 않으며 다음 행동을 안내하는가? |
| 오류 | 재시도할 수 있고 원인을 과도하게 노출하지 않는가? |
| 권한 없음 | 로그인·권한 요청 등 올바른 경로를 안내하는가? |
| 성공 | 데이터와 버튼 상태가 함께 갱신되는가? |
화면만 눈으로 보는 것도 부족하다. 키보드만으로 주요 기능에 접근할 수 있는지, 포커스 순서가 자연스러운지, 버튼에 접근성 이름이 있는지 확인한다. 작은 화면과 긴 번역 문자열에서는 요소가 겹치거나 잘리지 않는지도 봐야 한다.
빠른 연속 클릭과 느린 네트워크도 자주 놓치는 실패다. 한 번 누른 결제 버튼이 두 번 실행되거나, 먼저 보낸 요청의 늦은 응답이 최신 상태를 덮어쓰지 않는지 확인한다.
시각 회귀 테스트를 쓴다면 실행 환경을 고정한다.
await expect(page).toHaveScreenshot(
  "cart-empty.png",
  { maxDiffPixels: 50 },
);
운영체제, 브라우저, 글꼴이 달라지면 같은 코드도 픽셀이 달라진다. 기준 이미지는 CI의 고정된 환경에서 만들고, 허용할 차이도 숫자로 정한다.
2. 모바일: 함수보다 앱 생명주기와 실제 기기를 본다
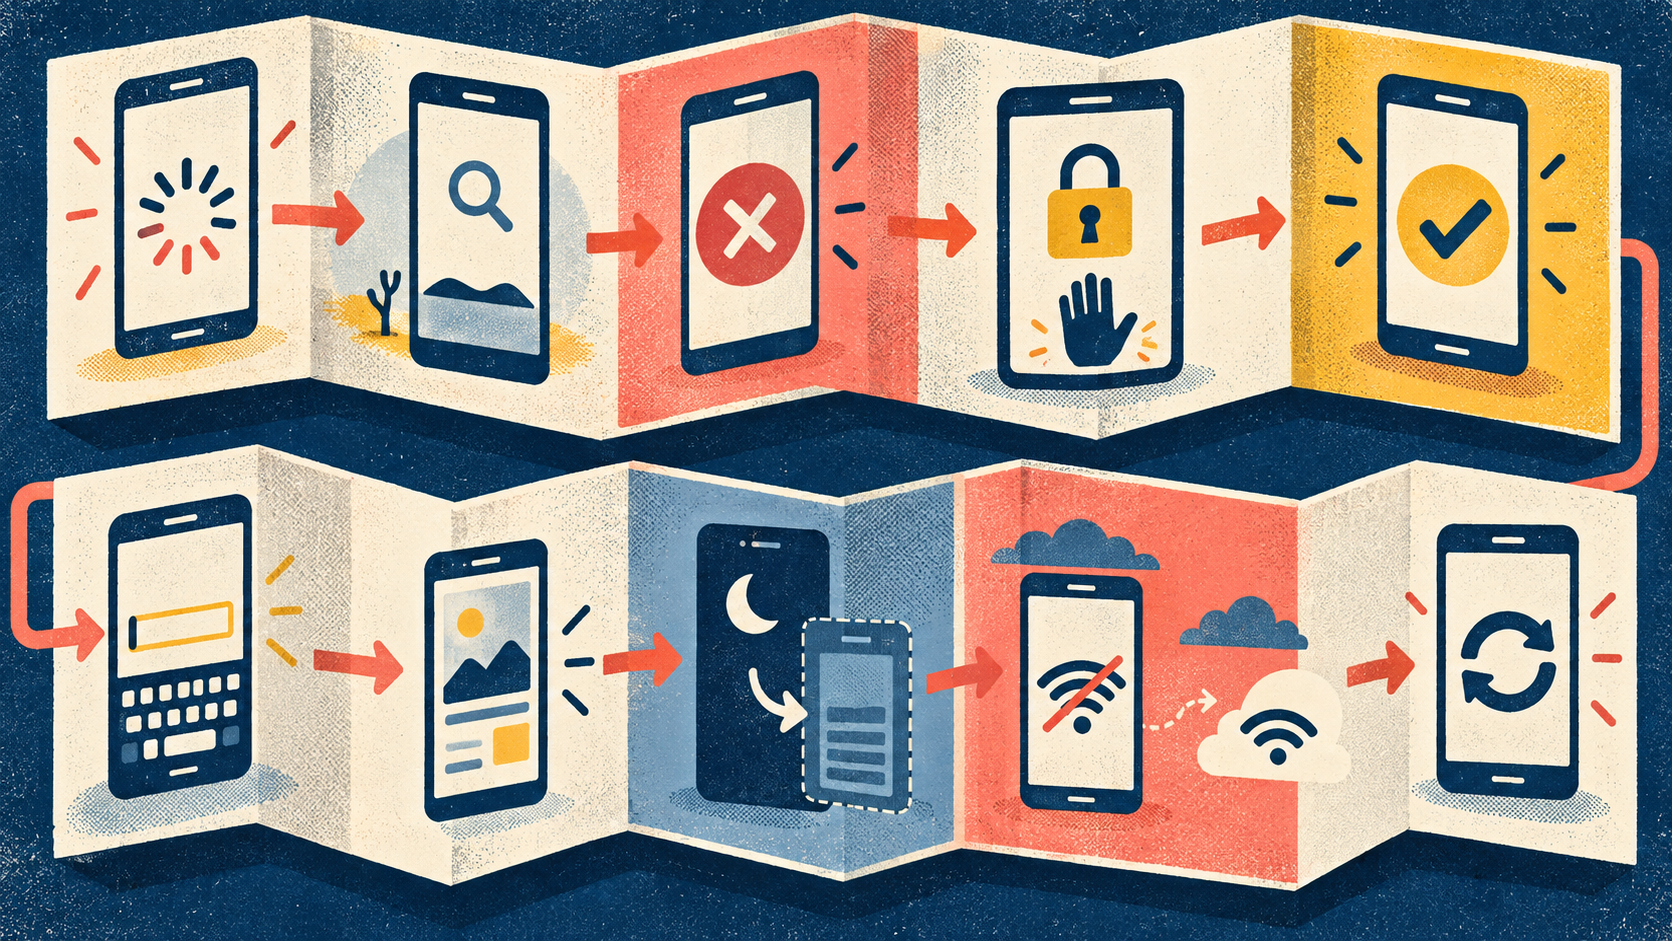
모바일 앱은 화면을 띄운 채 계속 실행되지 않는다. 사용자는 권한 팝업을 보고, 전화를 받고, 홈 화면으로 나갔다가 돌아오며, 네트워크가 끊긴 상태에서 저장 버튼을 누른다.
검증 층을 네 단계로 나누면 빠진 부분을 찾기 쉽다.
검증 층AI에게 맡길 초안사람이 확인할 것
| 단위 | 상태 변환과 경계값 테스트 | 도메인 규칙과 오류 의미 |
| 위젯 | 로딩·빈 화면·오류 상태 | 접근성, 포커스, 긴 문자열 |
| 통합 | 로그인·저장·복귀 흐름 | 권한 팝업, 백그라운드 복귀 |
| 기기 | 화면 크기별 사례 목록 | 성능, 배터리, 실제 센서 |
특히 다음 흐름은 별도 시나리오로 만든다.
- 카메라나 위치 권한을 처음 거부한 뒤 다시 허용하기
- 저장 중 앱을 백그라운드로 보냈다가 복귀하기
- 오프라인에서 작업한 뒤 네트워크가 복구되기
- 딥 링크로 앱을 열고 로그인 후 원래 화면으로 돌아가기
- 앱을 강제 종료한 뒤 작성 중 상태를 복원하기
에뮬레이터의 스크린샷 한 장으로 성공을 선언하지 않는다. 느린 기기에서 애니메이션이 끊기는지, 배터리와 메모리를 과도하게 쓰지 않는지, 실제 카메라·GPS·알림이 기대대로 동작하는지는 사람이 기기에서 확인해야 한다.
3. 데이터베이스: 같은 결과와 같은 비용은 다르다
AI가 제안한 SQL이 기존 쿼리와 같은 20개 행을 반환해도 안심할 수 없다. 기존 쿼리는 인덱스로 20개를 찾고, 새 쿼리는 백만 행을 읽은 뒤 20개를 남길 수 있다.
검증을 두 단계로 분리한다. 첫째, 복제본이나 안전한 테스트 데이터에서 결과가 같은지 확인한다. 둘째, 실행 계획을 보고 비용과 위험을 확인한다.
BEGIN;
SET TRANSACTION READ ONLY;

EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT id, created_at
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;

ROLLBACK;
EXPLAIN ANALYZE는 쿼리를 실제로 실행한다. 쓰기 문장이나 운영 데이터베이스에 무심코 사용하면 안 된다. 먼저 일반 EXPLAIN을 보고, 필요할 때만 읽기 전용 트랜잭션과 안전한 환경에서 실제 실행 통계를 확인한다.
실행 계획에서는 다음을 본다.
- 예상 행 수와 실제 행 수가 크게 다른가?
- 전체 테이블 스캔이 발생하는가?
- 같은 구간을 지나치게 많이 반복하는가?
- 정렬이 메모리를 넘어서 디스크를 사용하는가?
- 버퍼 읽기와 실행 시간이 기존 쿼리보다 늘었는가?
- 기대한 인덱스를 사용하고 있는가?
- 잠금을 더 오래 잡거나 더 넓은 범위를 막는가?
작은 테스트 데이터에서 5밀리초가 나왔다는 사실을 운영 성능으로 일반화하지 않는다. 데이터의 크기뿐 아니라 값의 분포와 동시 요청도 다르기 때문이다.
AI에게 요청할 때 스택별 완료 조건을 적는다
같은 “검증해줘”라도 다음처럼 구체화할 수 있다.
프론트엔드 요청 예시
로딩·빈 결과·오류·권한 없음 상태를 모두 구현하고, 키보드 탐색과 접근성 이름을 검사해줘. 360px와 1440px 뷰포트, 느린 네트워크와 연속 클릭 시나리오를 포함하고 시각 회귀 허용치는 50픽셀로 제한해줘.
모바일 요청 예시
단위·위젯·통합 테스트를 분리해줘. 권한 거부, 백그라운드 복귀, 오프라인 복구, 앱 재시작 뒤 상태 복원은 별도 시나리오로 작성하고 실제 기기에서 사람이 확인할 항목은 체크리스트로 남겨줘.
데이터베이스 요청 예시
운영 DB를 수정하지 말고 복제본에서 결과 동등성을 먼저 비교해줘. 일반 EXPLAIN 결과를 요약하고, 실제 실행이 필요한 경우 이유와 안전 조건을 먼저 제시해줘. 전체 스캔·행 수 추정·버퍼·정렬·인덱스·잠금 변화를 기존 계획과 비교해줘.
AI의 결과물에는 코드만 아니라 테스트 명령, 실행 환경, 비교 기준, 사람이 확인할 항목도 포함되어야 한다.
스택이 달라도 끝까지 남는 다섯 질문
- 사용자가 관찰할 수 있는 성공과 실패는 무엇인가?
- AI가 보지 못한 실행 환경은 무엇인가?
- 결과뿐 아니라 접근성·성능·권한·데이터를 어떻게 검사하는가?
- 동일한 환경에서 다시 실행할 수 있는가?
- 실패하면 어디까지 자동 복구하고 언제 사람에게 넘기는가?
좋은 검증은 테스트 개수를 늘리는 일이 아니다. 각 스택에서 실제로 망가질 수 있는 것을 관찰 가능하게 만드는 일이다.
문제를 작게 만든다. 실패를 재현한다. AI의 역할과 예산을 제한한다. 최소 변경을 확인한다. 테스트·정책·출처로 검증한다. 그리고 내 말로 설명해 동료에게 증거를 전달한다.
이 순서를 지키면 프레임워크가 바뀌어도 검증 습관은 남는다.
다음 글부터는 책의 워크북으로 넘어가, AI 활용 수준을 스스로 진단하고 30일 동안 무엇을 증거로 남길지 정리한다.
'Coding' 카테고리의 다른 글
| AI 코딩 실력, 총점보다 낮은 항목을 보세요: 10분 자가진단표 (0) | 2026.09.28 |
|---|---|
| 레거시 코드가 이상해 보여도 바로 고치지 마세요: 특성화 테스트 4단계 (0) | 2026.09.26 |
| 로컬 AI가 정말 더 쌀까? 클라우드와 비교할 때 꼭 재야 할 5가지 (0) | 2026.09.24 |
| AI가 ‘한 번만 더’를 반복할 때: 토큰 비용과 호출 횟수에 브레이크 거는 법 (0) | 2026.09.23 |
| AI에게 어디까지 맡겨도 될까? 위험도로 나누는 5단계 승인선 (0) | 2026.09.21 |


댓글