오래된 주문 금액 함수를 열었더니 계산 순서가 이상하다. 배송비를 먼저 결정하고 쿠폰을 나중에 적용한다. 쿠폰 사용 후 결제 금액
이 무료 배송 기준 아래로 내려가도 배송비는 여전히 0원이다.
“누가 봐도 버그 아닌가?”
이때 코드를 깔끔하게 고치고 싶은 충동이 생긴다. 하지만 운영 중인 레거시 코드에서는 이상한 동작도 누군가가 의존하는 정책일 수 있다. 고객 안내, 정산 자료, 다른 시스템의 계산 결과가 그 동작을 기준으로 맞춰져 있을지도 모른다.
그래서 레거시 코드의 첫 번째 목표는 개선이 아니다. 현재 무엇을 하고 있는지 증거로 고정하는 것이다.
특성화 테스트는 옳음을 증명하는 테스트가 아니다
일반적인 요구사항 테스트는 “시스템이 이렇게 동작해야 한다”를 표현한다. 특성화 테스트는 조금 다르다.
지금 이 시스템은 실제로 이렇게 동작하고 있다.
이 사실을 기록하는 것이 목적이다. 현재 동작이 비즈니스적으로 옳은지는 제품 담당자와 정책을 확인한 뒤 판단한다. 먼저 현실을 고정해야 변경 전후를 비교할 수 있다.
테스트가 없는 코드를 바로 리팩터링하는 것은, 사진 한 장 남기지 않고 오래된 기계를 분해하는 일과 비슷하다. 조립을 끝낸 뒤 원래대로 작동하는지 확인할 기준이 없다.
1단계: 이상한 동작을 관찰한다
예시 함수는 상품 합계를 계산하고, 그 금액으로 배송비를 먼저 결정한 뒤 쿠폰을 적용한다.
def legacy_total(items, vip=False, coupon=None):
    subtotal = sum(
        int(item["price"]) * int(item.get("qty", 1))
        for item in items
    )
    shipping = 0 if vip or subtotal >= 50_000 else 3_000
    if coupon == "WELCOME":
        subtotal -= 5_000
    return max(subtotal, 0) + shipping
5만 2천 원어치를 사고 5천 원 쿠폰을 사용하면 결제 금액은 4만 7천 원이다. 그런데 배송비는 쿠폰 적용 전 금액으로 이미 결정됐기 때문에 무료다.
여기서 바로 계산 순서를 바꾸지 않는다. 먼저 다음 질문을 적는다.
- 이 동작은 언제부터 존재했는가?
- 고객 화면과 정산 시스템도 같은 결과를 기대하는가?
- 쿠폰 정책 문서에는 어떤 순서가 적혀 있는가?
- 무료 배송을 받은 기존 고객과 결과가 달라져도 되는가?
코드만 보고 버그와 정책을 구분할 수 없을 때는 판단을 보류하는 것이 안전하다.
2단계: 현재 동작을 테스트로 얼린다
이상해 보이는 결과도 그대로 테스트에 기록한다.
import unittest

class LegacyTotalTest(unittest.TestCase):
    def test_coupon_does_not_change_shipping_rule(self):
        items = [{"price": 52_000, "qty": 1}]
        self.assertEqual(
            legacy_total(items, coupon="WELCOME"),
            47_000,
        )

    def test_vip_has_free_shipping(self):
        items = [{"price": 10_000, "qty": 1}]
        self.assertEqual(
            legacy_total(items, vip=True),
            10_000,
        )
첫 번째 테스트의 이름은 “올바른 무료 배송 정책”이라고 선언하지 않는다. 쿠폰이 배송 규칙을 바꾸지 않는다는 관찰 사실만 표현한다.
대표 사례만으로는 부족하다. 빈 장바구니, 수량 누락, 문자열 가격, 무료 배송 경계값, 쿠폰으로 금액이 0원 아래로 내려가는 경우도 함께 기록한다.
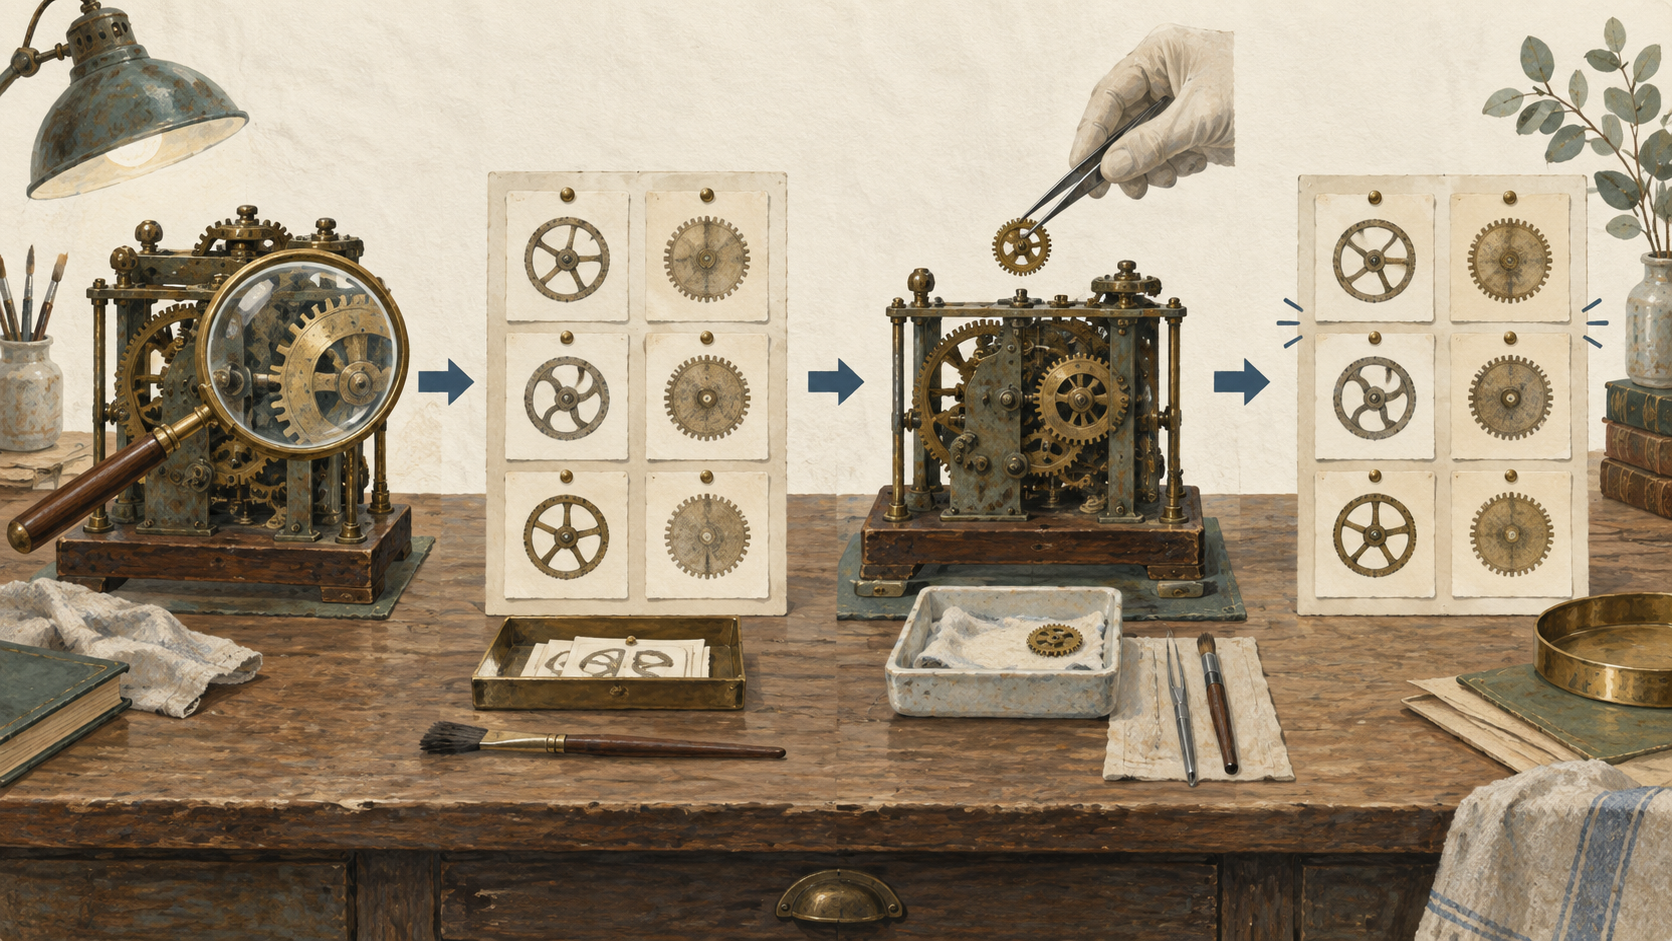
3단계: 결과를 바꾸지 않고 이름을 붙인다
안전망이 생긴 뒤에는 한 번에 하나씩 구조를 개선한다. 합계 계산과 배송비 결정을 작은 함수로 추출할 수 있다.
def subtotal_of(items):
    return sum(
        int(item["price"]) * int(item.get("qty", 1))
        for item in items
    )

def shipping_for(subtotal, vip):
    return 0 if vip or subtotal >= 50_000 else 3_000

def refactored_total(items, vip=False, coupon=None):
    subtotal = subtotal_of(items)
    shipping = shipping_for(subtotal, vip)
    if coupon == "WELCOME":
        subtotal -= 5_000
    return max(subtotal, 0) + shipping
새 함수가 더 예뻐 보인다는 사실은 검증이 아니다. 기존 함수와 새 함수에 같은 입력 묶음을 넣고 모든 결과가 동일한지 비교해야 한다.
for case in cases:
    assert legacy_total(**case) == refactored_total(**case)
구조 개선과 정책 변경도 같은 커밋에 섞지 않는다. 함수 추출 커밋은 결과를 보존하고, 배송 정책을 바꾸는 커밋은 제품 결정과 새로운 요구사항 테스트를 포함해야 한다.
4단계: AI에게도 작은 복원 구역만 준다
테스트 없는 수만 줄짜리 저장소를 AI에게 통째로 “현대화해줘”라고 요청하면 검토 범위가 폭발한다. AI의 역할을 다음처럼 잘게 나눈다.
- 호출되는 진입점 찾기
- 데이터베이스·파일·네트워크 부작용 정리하기
- 관찰할 입력과 출력 후보 만들기
- 특성화 테스트 초안 작성하기
- 한 번에 작은 함수 하나만 추출하기
- 기존 함수와 새 함수의 결과 비교하기
동시에 파일 수, 변경 줄 수, 실행 시간, 네트워크와 데이터베이스 접근을 제한한다. 모델은 패치를 제안하고, 사람은 정책과 변경 범위를 승인한다.
특성화 테스트에 꼭 담아야 할 다섯 가지
항목확인할 내용
| 대표 입력 | 실제 사용 빈도가 높은 정상 사례 |
| 경계값 | 무료 배송 기준처럼 결과가 바뀌는 지점 |
| 이상한 동작 | 사용자가 이미 의존할 수 있는 결과 |
| 부작용 | DB 기록, 파일 생성, 메시지 전송, 로그 |
| 이음새 | 외부 의존성을 가짜 구현으로 바꿀 위치 |
출력값만 같다고 끝내면 안 된다. 함수가 같은 값을 반환해도 데이터베이스에 쓰는 순서나 메시지 발송 횟수가 달라질 수 있다. 레거시에서는 부작용 역시 현재 동작의 일부다.
제품 담당자에게 물어볼 정책 질문
테스트로 현재를 기록한 다음, 비로소 정책을 확인한다.
- 쿠폰은 무료 배송 판단 전과 후 중 언제 적용해야 하는가?
- VIP 무료 배송은 할인 후 금액과 무관한가?
- 음수 합계를 0원으로 보정하는 것이 공식 정책인가?
- 기존 주문과 새 주문의 계산 방식이 달라도 되는가?
- 정책 변경 시 고객 안내나 데이터 보정이 필요한가?
답이 나오면 특성화 테스트를 지우는 것이 아니라, 새 요구사항 테스트를 추가한다. 변경 전 동작과 변경 후 정책의 차이가 코드 리뷰에서 선명하게 보여야 한다.
레거시에서 첫 성공의 기준
레거시 코드에서 첫 성공은 깨끗한 코드가 아니다.
- 현재 동작을 재현했다.
- 부작용의 경계를 찾았다.
- 이상하지만 사용 중인 결과를 기록했다.
- 작은 변경이 아무것도 깨뜨리지 않았음을 증명했다.
- 정책 변경을 구조 개선과 분리했다.
정답을 서둘러 구현하는 것보다 현재 시스템이 무엇을 약속하고 있는지 먼저 알아내는 편이 빠르다. 테스트 없는 레거시를 만났다면, 망치를 들기 전에 사진부터 찍자. 특성화 테스트는 오래된 코드에 처음으로 붙이는 안전벨트다.
다음 글에서는 프론트엔드·모바일·데이터베이스처럼 스택이 달라질 때 AI가 만든 코드를 무엇으로 검증해야 하는지 다룬다.
'Coding' 카테고리의 다른 글
| AI 코딩 실력, 총점보다 낮은 항목을 보세요: 10분 자가진단표 (0) | 2026.09.28 |
|---|---|
| AI가 만든 코드, 스택마다 검증법이 다릅니다: 프론트엔드·모바일·DB 체크리스트 (0) | 2026.09.27 |
| 로컬 AI가 정말 더 쌀까? 클라우드와 비교할 때 꼭 재야 할 5가지 (0) | 2026.09.24 |
| AI가 ‘한 번만 더’를 반복할 때: 토큰 비용과 호출 횟수에 브레이크 거는 법 (0) | 2026.09.23 |
| AI에게 어디까지 맡겨도 될까? 위험도로 나누는 5단계 승인선 (0) | 2026.09.21 |


댓글