CSV 저장이 끝났는지 확신할 수 없어 다시 실행했는데, 같은 데이터가 두 번 들어갔다면 ‘재실행 정책’이 빠져 있는지 확인해 보세요. 트랜잭션으로 한 번의 작업을 안전하게 묶어도, 이미 성공한 작업을 다시 실행하는 문제까지 해결되지는 않습니다.
이번 글에서는 Python과 SQLite로 같은 ID·같은 내용은 건너뛰고, 같은 ID·다른 내용은 충돌로 거부하는 가져오기 함수를 만듭니다. 같은 CSV를 두 번 실행한 뒤 실제 DB가 계속 2건인지 확인합니다.
교육용 실습이며 실제 장애 경험을 재구성한 글은 아닙니다. Windows·Python 3.11.9·SQLite 3.45.1에서 메모리 DB로 실행했습니다. 도해 3장은 AI 생성 설명 자료이며 실행 화면이 아닙니다.
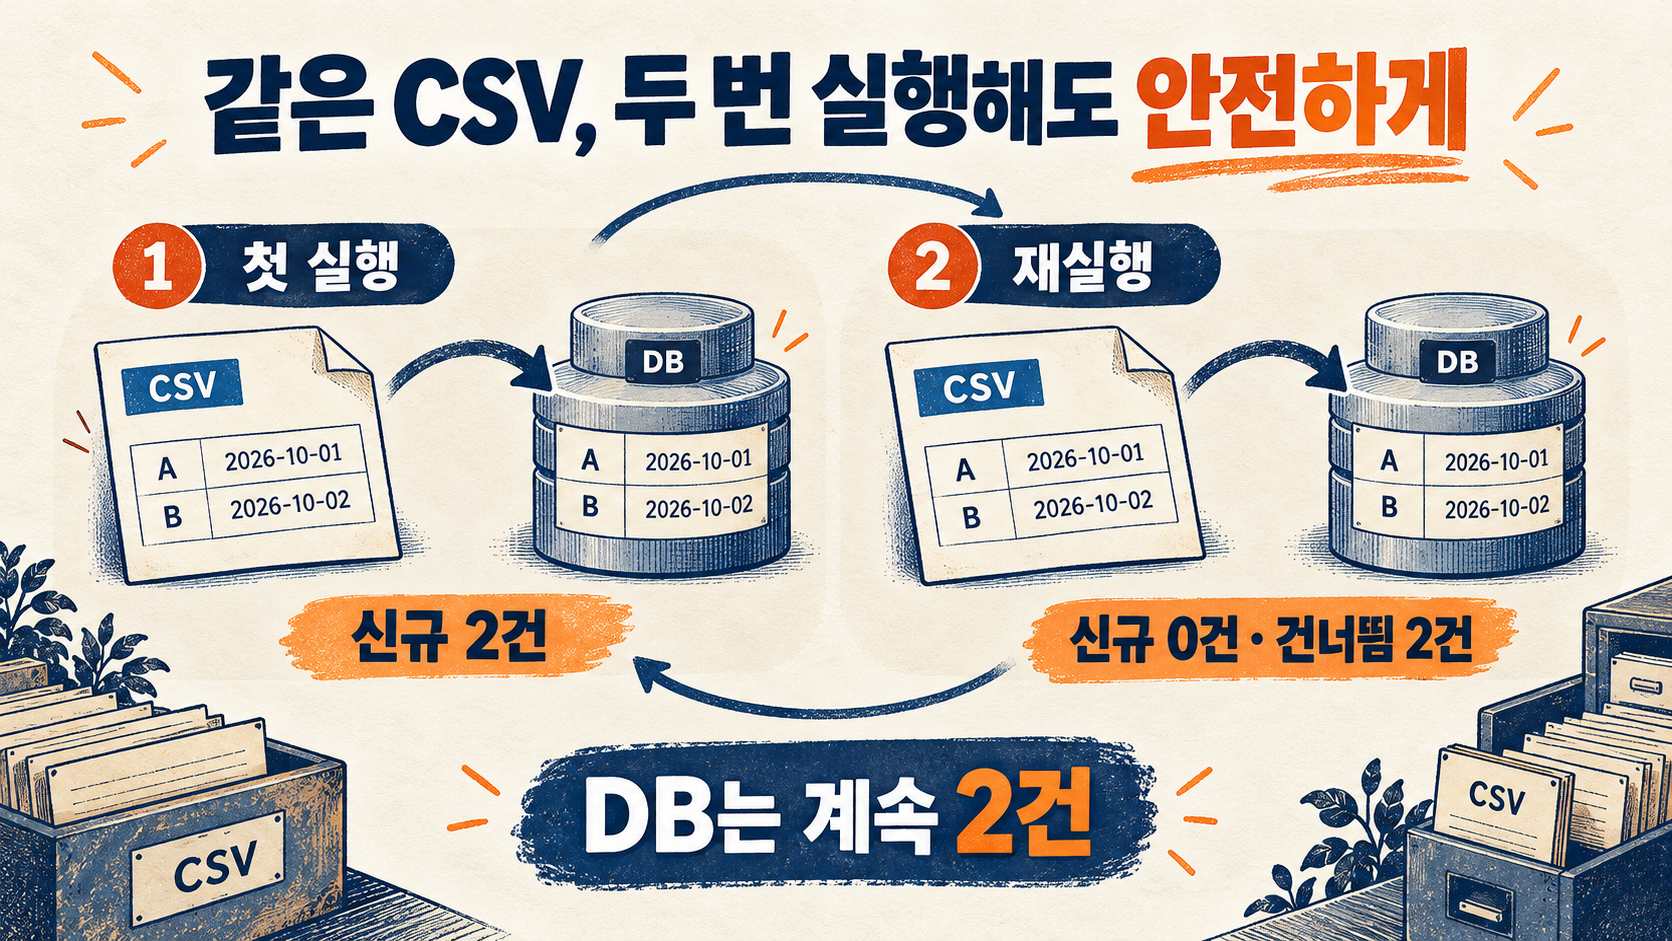
1. 트랜잭션만으로 재실행 중복이 사라지지는 않습니다
지난 편에서는 저장 도중 실패하면 이번 작업을 롤백했습니다. 하지만 첫 실행이 성공한 뒤 같은 INSERT를 다시 커밋하면, 중복을 막는 제약이 없는 테이블에는 같은 행이 추가됩니다.
다음 코드를 before.py로 저장해 실행하면 2건을 두 번 넣어 총 4건이 됩니다. 이 테이블은 문제 재현을 위해 일부러 기본 키를 두지 않았습니다.
import sqlite3

conn = sqlite3.connect(":memory:")
try:
    conn.execute("CREATE TABLE events (id TEXT, event_date TEXT)")
    rows = [("A", "2026-10-01"), ("B", "2026-10-02")]
    for _ in range(2):
        with conn:
            conn.executemany("INSERT INTO events VALUES (?, ?)", rows)
    print("without unique:", conn.execute("SELECT count(*) FROM events").fetchone()[0])
finally:
    conn.close()
PRIMARY KEY를 추가하면 같은 ID의 추가 삽입은 막을 수 있습니다. 다만 그것만으로는 ‘동일 요청의 안전한 반복’과 ‘잘못된 내용 충돌’을 구분하지 못합니다. INSERT OR IGNORE로 무조건 넘기면 기존 B의 날짜와 새 B의 날짜가 달라도 조용히 무시할 수 있습니다.
2. 같은 ID와 같은 내용을 따로 비교합니다
이 실습은 ID가 이벤트의 안정적인 식별자이고, 한 번 저장한 날짜를 이 가져오기 함수로 수정하지 않는다는 계약을 사용합니다. 날짜 변경은 별도의 수정 절차로 다룹니다.
DB와 입력의 관계처리
| ID가 없음 | 새 행 삽입 |
| ID와 날짜가 모두 같음 | 이미 반영된 행으로 건너뜀 |
| ID는 같지만 날짜가 다름 | 내용 충돌로 이번 가져오기 전체 취소 |
여기서 멱등성은 같은 입력을 반복해도 DB 상태가 더 바뀌지 않는 성질을 뜻합니다. 첫 실행의 saved=2와 재실행의 saved=0처럼 반환값은 달라도 됩니다. 이 예제는 파일 단위 작업 ID가 아닌, 행의 ID와 정규화된 날짜를 기준으로 판단합니다.
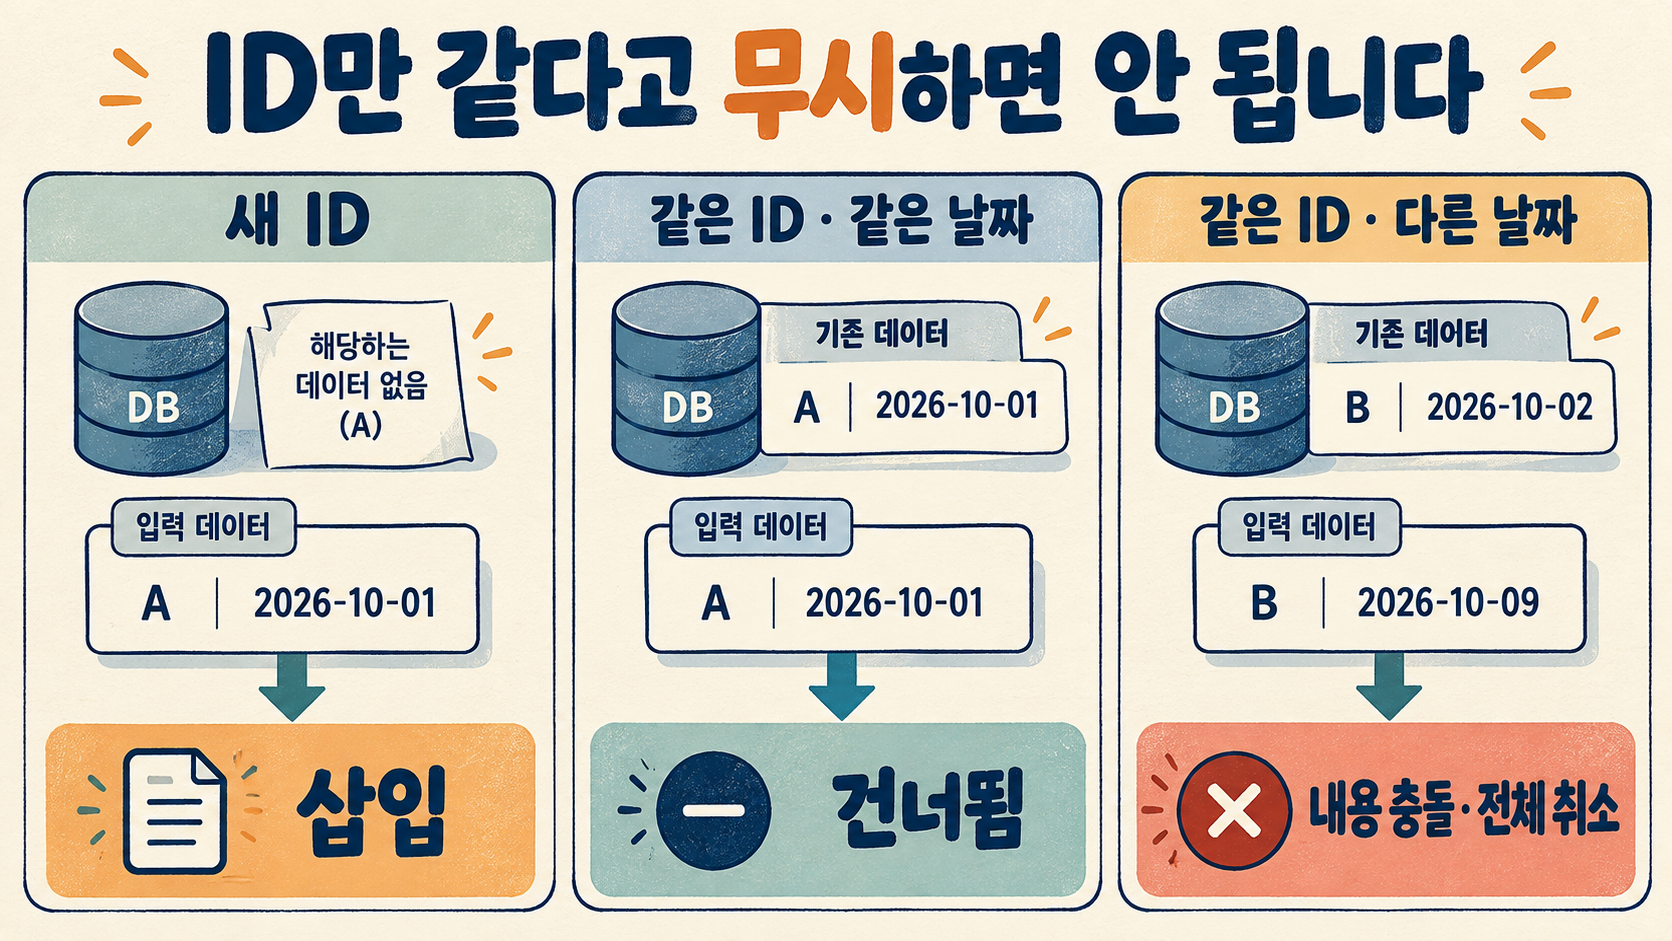
3. 검증이 끝난 뒤 하나의 저장 경계 안에서 비교합니다
먼저 CSV 중복 ID 검증 편의 inspect_csv 함수를 csv_duplicates.py로 준비합니다. 파일 안의 중복 ID·날짜 오류 등을 분류하는 함수입니다. 이번에는 검증 오류가 하나라도 있으면 전체 거부하며, 부분 성공 모드는 두지 않습니다.
아래 코드를 같은 폴더의 csv_retry.py에 저장하세요. 전용 기본 연결과 아래 실습의 두 열짜리 events 테이블을 전제로 합니다. 외부 패키지는 필요하지 않습니다.
from csv_duplicates import inspect_csv


class ContentConflict(Exception):
    pass


def import_once(conn, stream):
    if conn.isolation_level is None or conn.in_transaction:
        raise ValueError("use a default connection with no active transaction")
    report = inspect_csv(stream)
    if report["errors"]:
        return {"status": "rejected", "saved": 0, "skipped": 0}
    saved = skipped = 0
    try:
        with conn:
            conn.execute("BEGIN IMMEDIATE")
            for row in report["accepted"]:
                key, value = row["id"], row["date"]
                old = conn.execute(
                    "SELECT event_date FROM events WHERE id = ?", (key,)
                ).fetchone()
                if old is None:
                    conn.execute("INSERT INTO events VALUES (?, ?)", (key, value))
                    saved += 1
                elif old[0] == value:
                    skipped += 1
                else:
                    raise ContentConflict(key)
    except ContentConflict:
        return {"status": "conflict", "saved": 0, "skipped": 0}
    return {"status": "ok", "saved": saved, "skipped": skipped}
핵심은 SELECT와 INSERT를 같은 트랜잭션에 넣는 것입니다. BEGIN IMMEDIATE는 비교를 시작하기 전에 쓰기 트랜잭션을 요청합니다. SQLite는 동시 쓰기 트랜잭션을 하나만 허용하며, 이미 다른 쓰기 작업이 있으면 시작이 실패할 수 있습니다. 대기·재시도까지 자동 해결하는 명령은 아닙니다. SQLite 트랜잭션 공식 설명에서 잠금과 SQLITE_BUSY 조건을 확인할 수 있습니다.
ContentConflict를 with conn 바깥에서 처리하므로, 충돌 예외가 컨텍스트 관리자를 통과할 때 이번 삽입이 롤백됩니다. 정상 종료 때는 커밋합니다. 연결을 닫는 일은 별도입니다. Python 3.11 공식 문서의 연결 컨텍스트 관리자 동작을 적용했습니다.
이 예제는 기존 트랜잭션과 isolation_level=None 연결을 거부합니다. 다른 작업의 커밋·롤백 경계를 침범하지 않도록 범위를 좁힌 것입니다. Python의 다른 버전·연결 설정에 그대로 적용하기 전에 별도 확인이 필요합니다.
4. 첫 실행·재실행·내용 변경을 같은 DB에서 검사합니다
다음 코드를 check_retry.py로 저장하고 python check_retry.py를 실행합니다. :memory:를 쓰므로 실제 DB 파일은 수정하지 않습니다. 정상 CSV는 A와 B 두 행입니다. 마지막에는 새 C를 먼저 넣은 뒤, 기존 B와 날짜가 다른 행을 넣어 롤백 여부를 확인합니다.
import io
import platform
import sqlite3
from csv_retry import import_once

conn = sqlite3.connect(":memory:")
try:
    conn.execute("CREATE TABLE events (id TEXT PRIMARY KEY NOT NULL, event_date TEXT NOT NULL)")
    print("Python", platform.python_version(), "SQLite", sqlite3.sqlite_version)
    sample = "id,date\nA,2026-10-01\nB,2026-10-02\n"
    for label in ("first", "retry"):
        result = import_once(conn, io.StringIO(sample))
        print(label, result, "DB rows =", conn.execute("SELECT count(*) FROM events").fetchone()[0])
    changed = "id,date\nC,2026-10-03\nB,2026-10-09\n"
    print("changed", import_once(conn, io.StringIO(changed)))
    remaining = conn.execute("SELECT * FROM events ORDER BY id").fetchall()
    print("remaining", remaining)
    assert remaining == [("A", "2026-10-01"), ("B", "2026-10-02")]
finally:
    conn.close()
직접 실행한 결과는 다음과 같습니다.
Python 3.11.9 SQLite 3.45.1
first {'status': 'ok', 'saved': 2, 'skipped': 0} DB rows = 2
retry {'status': 'ok', 'saved': 0, 'skipped': 2} DB rows = 2
changed {'status': 'conflict', 'saved': 0, 'skipped': 0}
remaining [('A', '2026-10-01'), ('B', '2026-10-02')]
반환값만 보지 않고 최종 행의 ID와 날짜까지 확인합니다. 마지막 작업에서 C는 잠시 삽입됐지만 B의 내용 충돌로 롤백돼 남지 않았습니다. 기존 A·B는 그대로입니다. 실패 응답의 saved·skipped는 모두 0으로 정하며, 작업 도중 시도한 횟수를 보고하지 않습니다.
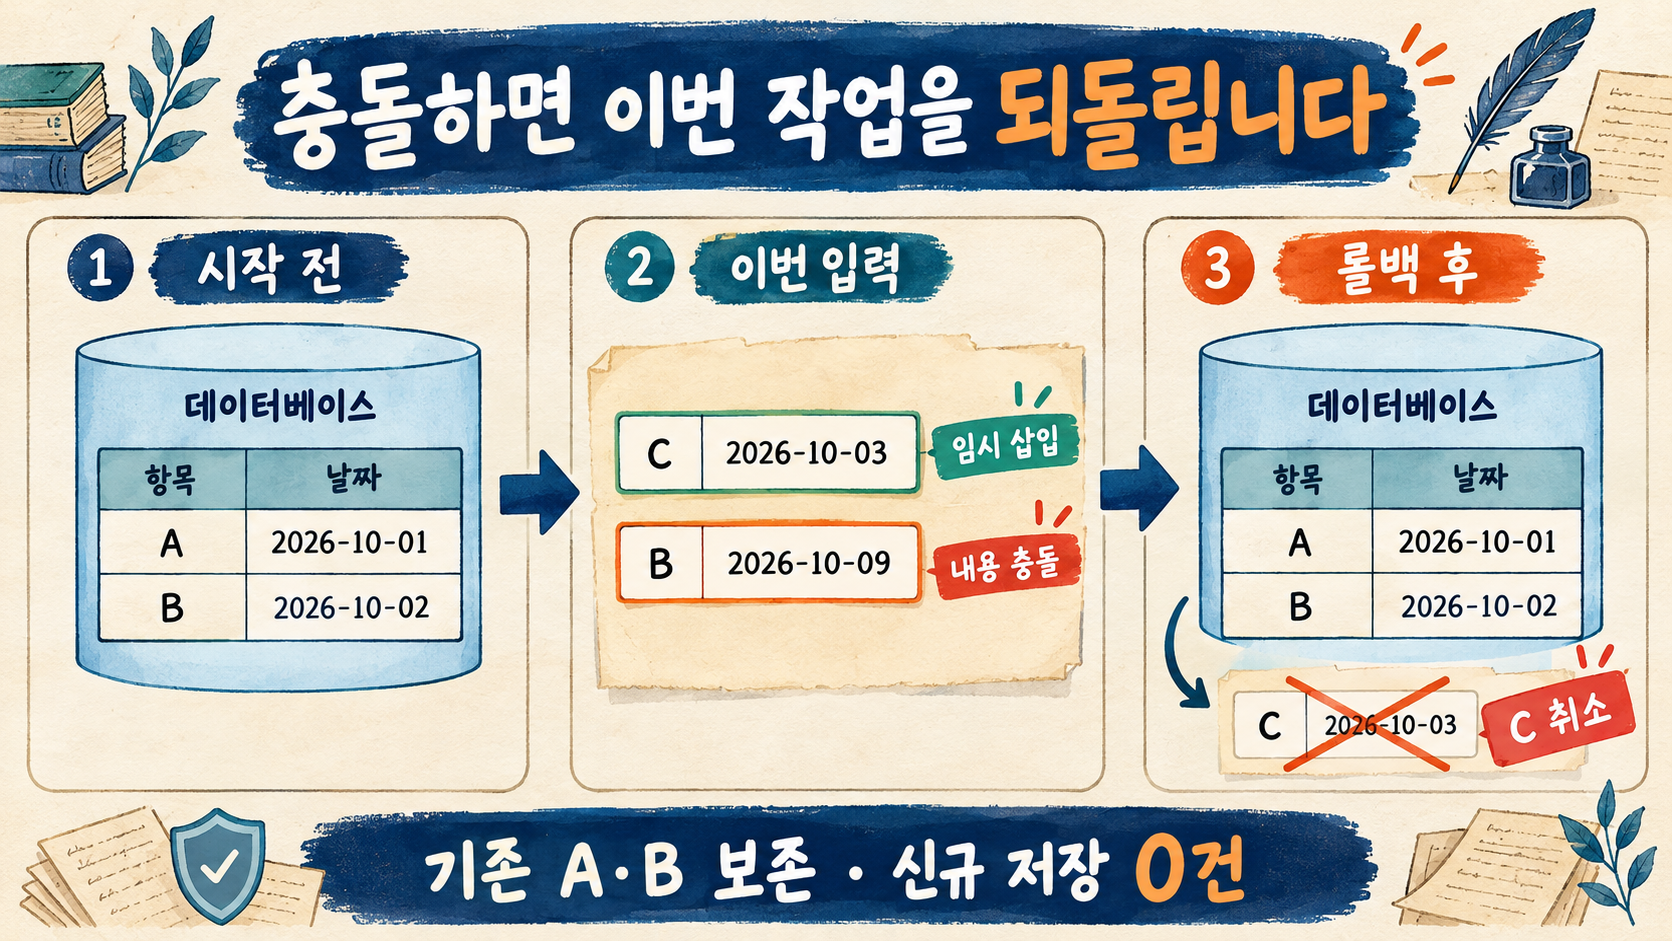
5. 재실행뿐 아니라 실패 경계도 테스트합니다
로컬 자동 테스트 12개를 실행했고 모두 통과했습니다. 단일 연결·메모리 DB에서 확인한 결과입니다.
- 첫 실행의 신규 저장과 실제 DB 행 확인
- 동일 CSV 재실행: saved=0, skipped=2, DB는 2건
- 이미 있는 행과 새 행이 섞인 입력: 건너뜀 1건·신규 1건
- 새 C 삽입 뒤 B 내용 충돌: C 취소, 기존 B 보존
- 날짜 누락과 파일 내부 중복 ID: 각각 전체 거부
- 잘못된 헤더와 CSV 구문 오류: 각각 저장 전 예외
- 기존 트랜잭션과 자동 커밋 연결: 각각 실행 거부
- DB 트리거로 삽입 실패를 주입: 앞서 삽입한 행까지 롤백하고 예외 전파
- 앞뒤 공백 정규화 후 재실행, 헤더만 있는 빈 입력
rejected는 CSV 검증 실패, conflict는 기존 DB와의 내용 충돌입니다. 이 짧은 함수는 상태만 반환하므로, 행별 검증 이유가 필요하면 inspect_csv의 errors를 응답 스키마에 추가하세요. 그 밖의 DB 오류는 성공으로 삼키지 않고 호출부로 전파합니다.
이 예제가 보장하지 않는 것
- DB 밖의 효과: 이메일·파일 업로드·외부 API 호출은 이 트랜잭션이 되돌리지 못합니다. ‘전체 시스템이 정확히 한 번 실행된다’는 보장이 아닙니다.
- 동시성 부하와 재시도: 다중 프로세스 부하·잠금 경합 테스트는 수행하지 않았습니다. OperationalError를 무한 재시도하지 말고 원인을 분류하고 재시도 횟수·대기 한도를 정해야 합니다.
- 범용 데이터 동일성: 이 예제의 내용은 정규화된 날짜 한 필드뿐입니다. 금액·상태 등 필드가 늘면 비교할 업무 필드와 수정 정책도 늘려야 합니다. ID는 대소문자를 구분합니다.
- 파일 단위 중복 판정: 파일명이나 파일 해시·멱등 키를 저장하지 않습니다. 행 순서가 달라도 같은 ID·날짜면 건너뛰지만, 작업 이력이나 이전 응답을 재현하는 기능은 없습니다.
- 대용량·임의 스키마: 검증 함수는 전체 파일을 메모리에 읽으며 행마다 조회합니다. 대용량 성능, 다른 DB·ORM, 사용자 정의 row_factory, 추가 열·트리거가 있는 테이블은 별도 설계·검증 대상입니다.
AI에게 저장 코드를 맡길 때도 “중복 안 생기게 해 줘”에서 끝내지 말고 무엇을 같은 작업으로 볼지, 같은 ID의 내용이 달라지면 어떻게 할지, 실패 후 무엇을 다시 시도할지를 먼저 적어 보세요. 책에서 강조한 안전한 재실행과 명확한 도구 계약을 작은 저장 함수에 적용하는 방법입니다.
관련 실습: SQLite 트랜잭션으로 부분 저장 막기 · CSV 중복 ID 검증 · CSV 날짜 오류와 누락된 행 찾기
《AI 시대의 주니어 개발자》의 ‘동일 입력 재실행 안전성’과 ‘멱등성·재시도 정책을 문서화한다’는 원칙을 코드로 적용한 실습입니다. 실제 검증 환경은 Windows·Python 3.11.9·SQLite 3.45.1입니다.
'Coding > Python' 카테고리의 다른 글
| Python CSV 저장 중 오류가 나면? SQLite 트랜잭션으로 부분 저장 막기 (0) | 2026.10.20 |
|---|---|
| Python CSV 중복 ID 검증: 딕셔너리 덮어쓰기를 막고 오류 행 찾기 (0) | 2026.10.17 |
| Python CSV 날짜 오류 처리: 누락된 행을 찾고 정상·오류 건수 검증하기 (0) | 2026.10.14 |
| VSCode Python 가상환경 오류 해결하기 - PowerShell 실행 정책 변경 (0) | 2025.11.23 |
| 🔧 [FastAPI] uvicorn 실행 시 "OS file watch limit reached" 오류 해결하기 (0) | 2025.07.08 |


댓글