오후 배포가 끝난 뒤 이런 제보를 받았습니다.
검색 결과가 분명히 있는데, 어떤 검색어에서는 빈 화면이 나옵니다.
코드를 열자마자 눈에 들어온 조건문 하나를 고쳤습니다. 로컬에서는 잘 되는 것 같았습니다. 그런데 다시 확인해 보니 원래 잘 나오던 검색 결과가 중복됐습니다. 첫 번째 수정은 원인을 해결한 것이 아니라 증상을 다른 곳으로 옮긴 셈이었습니다.
디버깅에서 가장 위험한 순간은 오류를 발견했을 때가 아닙니다. 원인을 안다고 너무 빨리 확신했을 때입니다.
디버깅은 정답을 떠올리는 능력보다, 가능한 원인을 세우고 가장 싼 실험으로 하나씩 지우는 능력에 가깝습니다.
디버깅의 순서는 ‘수정’이 아니라 ‘관찰 → 가설 → 실험 → 기각’이다
오류 메시지를 AI에게 붙여 넣고 “고쳐줘”라고 말하면 그럴듯한 수정안은 빠르게 나옵니다. 하지만 재현 조건과 증거가 부족하면 AI도 눈에 띄는 코드에 먼저 손을 댑니다.
좋은 디버깅은 다음 네 단계를 반복합니다.
- 기대 결과와 실제 결과의 차이를 구체적으로 관찰한다.
- 가능한 원인을 여러 개 세운다.
- 원인을 구분할 수 있는 가장 작은 실험을 한다.
- 결과와 맞지 않는 가설을 기각한다.
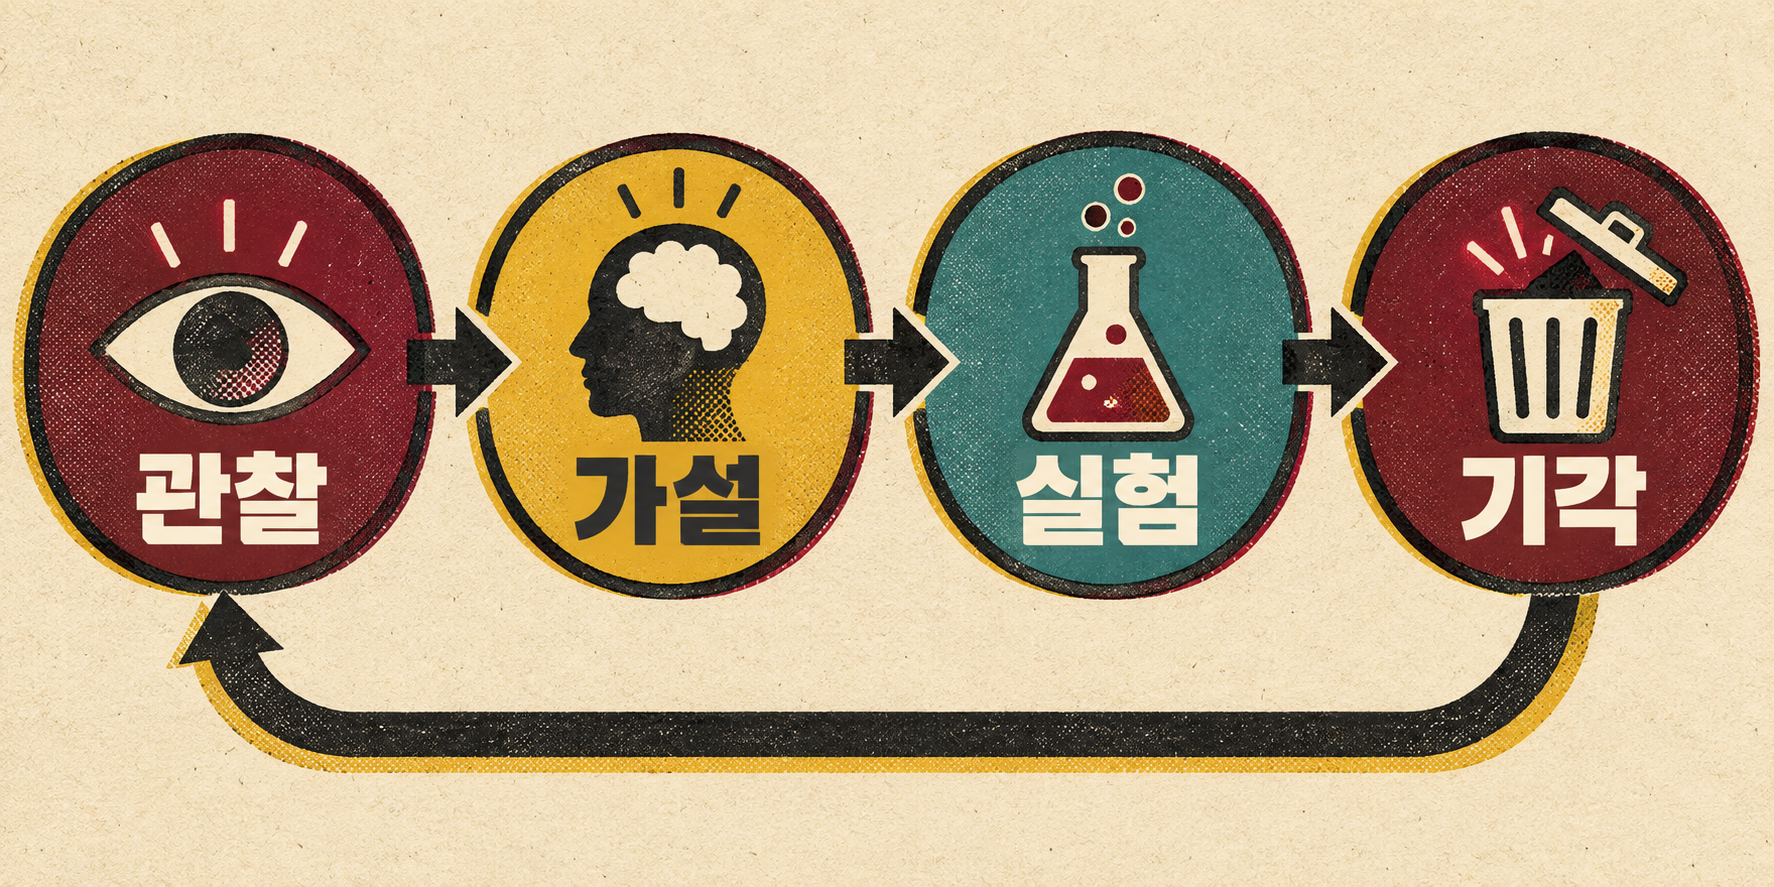
핵심은 첫 번째 가설을 곧바로 정답으로 취급하지 않는 것입니다. 가설은 맞다고 증명하기 위한 이야기가 아니라, 틀렸는지 빠르게 확인하기 위한 임시 설명입니다.
1단계. 기대 결과와 실제 결과를 각각 한 문장으로 적기
“검색이 이상하다”는 디버깅을 시작하기에 너무 넓습니다. 정상이라면 무엇이 일어나야 하고 실제로 무엇을 보았는지 분리해서 적습니다.
- 기대 결과: notebook을 검색하면 일치하는 상품 12개가 10개씩 페이지로 나뉘어 표시된다.
- 실제 결과: 첫 페이지에 11개가 나오고, 마지막 상품이 두 번째 페이지의 첫 상품과 겹친다.
이렇게 적으면 네트워크 장애, 검색 결과 부재, 화면 렌더링 실패보다 페이지 구간 계산을 먼저 의심할 근거가 생깁니다.
2단계. 누구나 따라 할 수 있는 재현 절차와 증거 남기기
재현 절차는 개발자의 기억이 아니라 다른 사람이 그대로 실행할 수 있는 순서여야 합니다.
- 상품 데이터 20개를 준비한다.
- 페이지 크기를 10으로 설정한다.
- 첫 페이지와 두 번째 페이지를 차례로 요청한다.
- 각 페이지의 개수와 두 페이지의 교집합을 확인한다.
함께 남길 증거도 정합니다.
- 오류 메시지와 로그 원문
- 요청 URL과 입력값
- 실제 응답 또는 화면 캡처
- 최근 변경된 코드
- 발생 환경과 재현 빈도
로그를 요약해서 옮기기보다 원문을 보존하는 편이 좋습니다. 작은 숫자 하나, 경로 하나가 가설의 순서를 바꿀 수 있기 때문입니다.
3단계. 가능한 원인 세 개를 가능성 순으로 세우기
페이지 중복 현상이라면 다음처럼 가설을 세울 수 있습니다.
순위가능한 원인먼저 보는 이유
| 1 | 종료 인덱스가 한 칸 크게 계산됐다 | 첫 페이지가 정확히 하나 더 많다 |
| 2 | 페이지 번호를 0부터 시작한다고 가정했다 | 첫 페이지의 시작 위치가 흔히 어긋나는 지점이다 |
| 3 | 서버 응답은 정상인데 화면에서 이전 목록을 합쳤다 | API 결과와 화면 결과가 다를 수 있다 |
여기서 “왠지 1번 같다”는 결론이 아닙니다. 이제 가설끼리 구분할 실험을 설계할 차례입니다.
4단계. 가장 싼 실험과 반증 조건 정하기
좋은 실험은 작고 빠르며, 결과가 어느 가설을 지우는지 분명합니다.
가설가장 작은 실험틀렸음을 보여 주는 반증 조건
| 종료 인덱스 오류 | 첫 페이지 결과 길이가 10인지 검사 | 길이가 정확히 10이다 |
| 페이지 시작점 오류 | 두 페이지의 첫 인덱스를 기록 | 시작 인덱스가 0과 10으로 정확하다 |
| 화면 병합 오류 | API 원문과 화면 배열을 따로 비교 | API 응답부터 이미 중복되어 있다 |
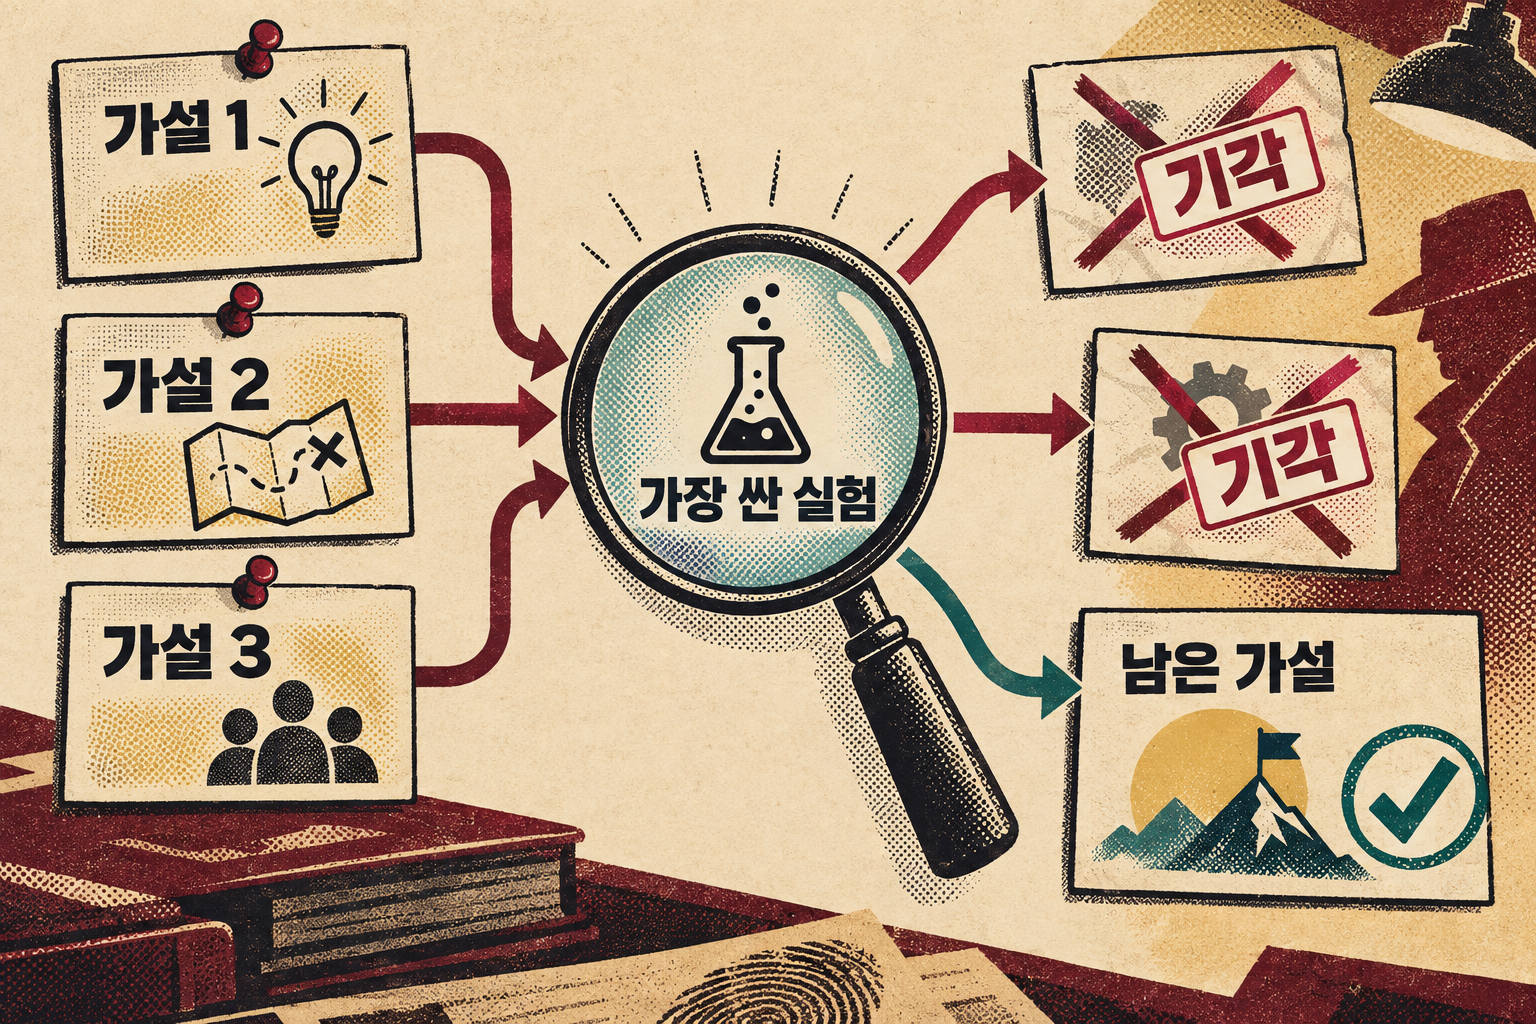
이 방식의 장점은 코드를 무작정 고치지 않아도 조사 범위가 빠르게 줄어든다는 것입니다. 첫 실험에서 페이지 길이가 11이라면 화면 상태를 뒤지는 대신 종료 인덱스 계산을 먼저 볼 수 있습니다.
예를 들어 아래 구현에는 작은 차이가 숨어 있습니다.
def paginate(items, page, page_size):
    start = (page - 1) * page_size
    end = start + page_size + 1
    return items[start:end]
len(paginate(items, 1, 3)) == 3을 확인하는 테스트와 인접한 두 페이지의 교집합이 비어 있는지 확인하는 테스트를 먼저 실행하면, 수정 전에 증상을 고정할 수 있습니다.
원인을 확인한 뒤에야 end = start + page_size라는 최소 변경을 검토합니다. 그리고 마지막 페이지, page=0, page_size=0 같은 경계 조건까지 확인해야 수정이 끝납니다.
AI에게는 수정안보다 ‘가설과 반증 조건’을 먼저 요청하기
다음 틀을 기능이나 오류에 맞게 바꿔 사용해 보세요.
기대 결과: [정상이라면 일어나야 할 일]
실제 결과: [관찰한 증상]
재현 절차: [누구나 따라 할 수 있는 단계]
오류·로그: [요약하지 않은 원문]
최근 변경: [있다면]아직 수정 코드를 주지 마. 가능한 원인 3개를 가능성 순으로 제시해 줘. 각 원인마다 확인할 관찰, 가장 작은 실험, 틀렸음을 보여 주는 반증 조건을 적어 줘. 내가 실험 결과를 알려 준 뒤에만 최소 수정안을 제안해 줘.
AI가 제시한 가설도 검증 전에는 추측입니다. 존재하지 않는 설정이나 호출 경로를 그럴듯하게 말할 수 있으므로, 실제 코드·로그·테스트 결과와 연결해 확인합니다.
오늘 바로 해 보는 20분 연습
최근에 해결했던 버그 하나를 다시 꺼내 봅니다. 정답을 알고 있어도 괜찮습니다.
- 기대 결과와 실제 결과를 각각 한 문장으로 적습니다.
- 재현 절차를 네 단계 이내로 씁니다.
- 가능한 원인 세 개를 가능성 순으로 적습니다.
- 각 가설의 가장 싼 실험과 반증 조건을 정합니다.
- 실험 결과로 기각된 가설과 남은 가설을 표시합니다.
- 수정 후 같은 버그를 막는 테스트 한 개를 남깁니다.
20분이 끝났을 때 정답보다 중요한 산출물은 왜 이 원인을 의심했고, 어떤 증거로 다른 원인을 지웠는지 설명할 수 있는 기록입니다.
다음 글에서는 테스트를 단순한 오류 검사기가 아니라, 정상·경계값·권한·외부 실패까지 표현하는 요구사항의 언어로 사용하는 방법을 다루겠습니다.
이번 글의 한 문장
디버깅은 가장 그럴듯한 원인을 바로 고치는 일이 아니라, 관찰에서 가설을 세우고 가장 싼 실험과 반증 조건으로 틀린 설명을 지워 가는 일이다.
'Coding' 카테고리의 다른 글
| AI가 만든 PR, 코드부터 읽지 마세요: 큰 변경을 검토하는 6단계 (0) | 2026.09.15 |
|---|---|
| 테스트는 버그를 찾는 도구가 아닙니다: 요구사항을 코드로 번역하는 5가지 질문 (0) | 2026.09.15 |
| 처음 보는 저장소, 어디서부터 읽을까? 30분 만에 코드 지도 만드는 5단계 (0) | 2026.09.11 |
| 큰 기능을 1~2시간 작업으로 나누는 법: AI 코딩이 덜 헤매는 작업 분해 5단계 (0) | 2026.09.10 |
| AI 코딩 후 반드시 직접 확인할 6가지: 테스트 통과만 믿으면 안 되는 이유 (1) | 2026.09.09 |


댓글